Le cloaking consiste à montrer une version d'une page à un robot et une autre version à un visiteur humain. C'est toute la définition, et elle recouvre deux pratiques très différentes qu'on confond en permanence : une technique trompeuse que Google sanctionne, et une étape de filtrage banale que la plupart des gros sites appliquent sans jamais l'appeler cloaking.
Savoir laquelle vous pratiquez a son importance, parce que l'une peut vous coûter votre visibilité dans la recherche et l'autre sert simplement à sortir les robots de vos chiffres.
Qu'est-ce que le cloaking en SEO ?
La définition que Google utilise
En référencement, le cloaking consiste à servir à Googlebot un contenu différent de celui que voit une personne, dans le but de modifier le classement de la page. Montrer au robot une page bourrée de mots-clés pendant que les visiteurs voient une galerie photo, c'est le cas d'école.
C'est une violation des règles anti-spam de Google, et la sanction est la sortie de l'index. Ce n'est pas une zone grise, et il n'existe pas de version maligne qui tienne dans la durée.
Pourquoi certains essaient quand même
Parce que ça semble marcher pendant quelques semaines. Une page se positionne sur des termes qu'elle ne mérite pas, le trafic arrive, puis le site disparaît des résultats sans préavis et sans retour facile. Le gain est temporaire, la perte est définitive.
Si vous optimisez une page pour la recherche, la réponse honnête est que le robot et le visiteur doivent voir la même chose.
Le cloaking appliqué au routage de liens est un autre sujet
Le mot désigne aussi quelque chose qui n'a rien à voir avec le classement : décider de ce que reçoit une requête automatisée quand elle arrive sur un lien, par opposition à ce que reçoit une vraie personne.
Chaque lien que vous publiez sur une plateforme sociale est récupéré par des machines avant, et souvent à la place, d'être récupéré par des humains. Générateurs d'aperçu, scanners de sécurité, filtres anti-spam, services de monitoring et scrapers demandent tous l'URL. Certains s'identifient honnêtement. Beaucoup non.
Pourquoi filtrer
Trois raisons, dont aucune ne concerne le référencement.
La mesure. Si un tiers des requêtes qui touchent votre lien sont automatisées, votre compteur de clics est une fiction et toutes les décisions que vous en tirez sont fausses. Séparer les machines des humains, c'est la différence entre de l'analytics et du bruit.
Le contrôle de l'aperçu. Quand un lien est partagé, l'aperçu est généré par un robot qui lit les métadonnées de votre page. Maîtriser ce que ce robot reçoit, c'est maîtriser la carte d'aperçu, ce qui fait partie du travail normal de publication d'un lien.
La protection contre le scraping. Un lien qui répond à l'identique pour tout le monde se moissonne à grande échelle sans effort. Filtrer les requêtes automatisées est une pratique courante, c'est la même logique que derrière n'importe quel limiteur de débit ou produit de gestion de bots du marché.
Où passe la limite
Voici la distinction qui compte, et elle mérite d'être posée avec précision.
Filtrer du trafic automatisé pour garder des statistiques propres et éviter que votre contenu soit aspiré, c'est de l'infrastructure ordinaire. Servir un contenu trompeur aux systèmes de vérification d'une plateforme pour publier quelque chose qui serait autrement refusé, c'est autre chose, ça enfreint les conditions de la plateforme, et ça met le compte en danger au lieu de le protéger.
Nous ne construisons pas pour ce second cas et nous ne le recommandons pas. Si une destination ne peut pas passer la vérification d'une plateforme, la réponse est de changer la destination, pas de la cacher. C'est une réponse plus difficile, et c'est la seule qui survit à une équipe de modération.
Ce que fait LinkScale concrètement
Notre couche de filtrage est construite pour le premier cas : distinguer les machines des humains, et les traiter différemment.
| Ce qui arrive | Ce que ça reçoit | Pourquoi |
|---|---|---|
| Un vrai visiteur | Votre page, avec un routage vers son propre navigateur plutôt que vers un navigateur intégré | Moins d'étapes entre lui et votre destination |
| Un robot d'aperçu | Des métadonnées propres pour la carte de partage | Le lien s'affiche correctement quand il est partagé |
| Une requête de datacenter, un proxy ou un scraper connu | Une réponse neutre | Ce n'est pas un visiteur, il ne doit pas être compté comme tel |
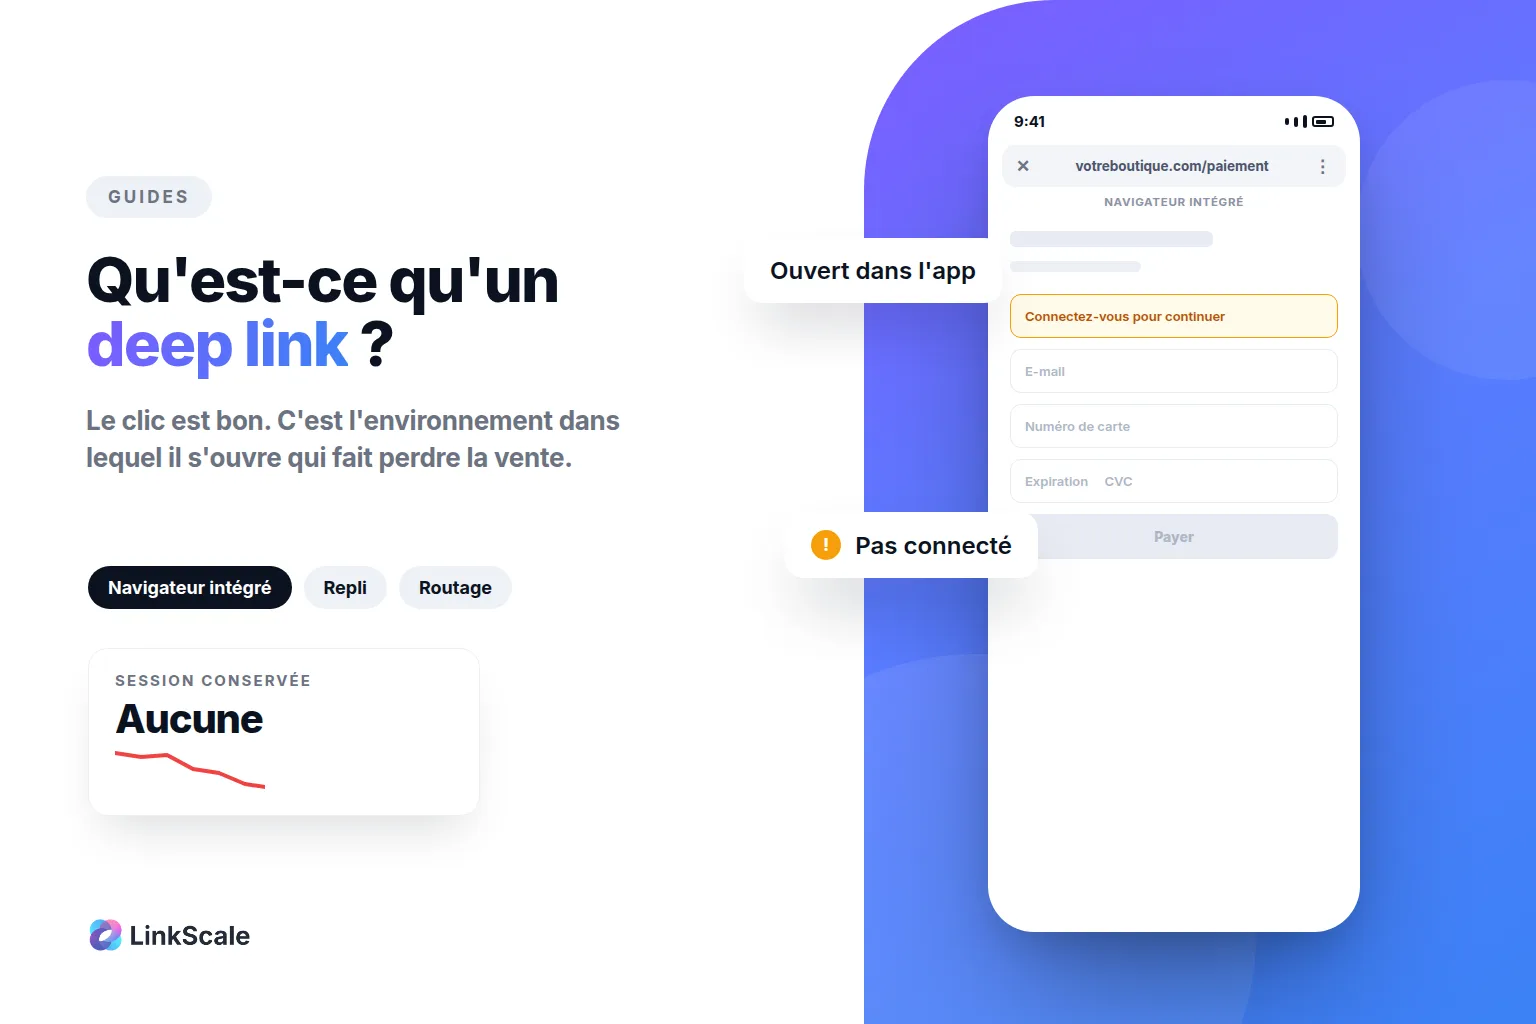
Le routage compte autant que le filtrage. Un visiteur qui atterrit dans le navigateur intégré d'une application sociale n'est pas connecté et n'a pas ses moyens de paiement enregistrés, ce qui explique qu'une même page convertisse différemment selon l'endroit où elle s'ouvre. Le mécanisme est détaillé sur notre page dédiée aux deeplinks.
La qualité de trafic est le résultat utile
L'intérêt de séparer les machines des humains, ce n'est pas la séparation elle-même, c'est le chiffre qu'on obtient après.
Une fois les requêtes automatisées écartées, votre compteur de clics veut dire quelque chose. Vous pouvez comparer les plateformes honnêtement, voir quelle source envoie des gens qui arrivent réellement, et arrêter d'optimiser des campagnes contre des chiffres gonflés. Notre page qualité de trafic détaille les signaux utilisés, et la page analytics ce que vous voyez.